Cómo construimos la plataforma de datos de Akua: una capa a la vez
Cómo servimos datos exactos, aislados y frescos a cada banco, cliente y comercio que opera sobre Akua, y por qué ninguna pieza de nuestra arquitectura es definitiva.
Un pago con tarjeta deja rastro en varios servicios antes de cerrarse. La autorización vive en el servicio online. La presentación a la red vive en clearing. La confirmación de Visa o Mastercard llega en archivos de la red. Los fees, los impuestos y las retenciones se calculan en el motor de impuestos y retenciones, que también define la liquidación al comercio. La foto completa de esa transacción se arma entre el día de la compra y las 24 horas siguientes.
Esa fragmentación no es un accidente. Akua se pensó desde el primer día como una plataforma para escalar regionalmente, con cada dominio como un servicio independiente y dueño de sus datos. Nuestro modelo de negocio le suma dos dimensiones más: bancos y procesadoras operan sobre Akua como tenants, cada uno con sus clientes y sus comercios, y lo hacen en varios países, cada uno con sus impuestos y sus formatos.
La misma transacción tiene que llegarle completa a cada actor que la tocó. Y solo a él.
De ahí salen tres exigencias que no se negocian:
- Exactitud. La conciliación es dinero. Un centavo de diferencia entre lo que confirmó la red y lo que reportamos es un problema del cliente, no un detalle técnico.
- Aislamiento. Cada tenant, cada cliente y cada comercio ve sus datos y nada más.
- Frescura. Operaciones necesita saber en minutos, no al día siguiente, que un emisor dejó de aprobar.
No hay una herramienta que resuelva las tres de una vez. Lo que sí funciona es una arquitectura modular, que genera valor desde el primer día y crece al ritmo de la operación.
En este post seguimos ese mismo pago de punta a punta. En cada tramo contamos qué problema aparece, cómo lo resolvimos y qué aprendimos.
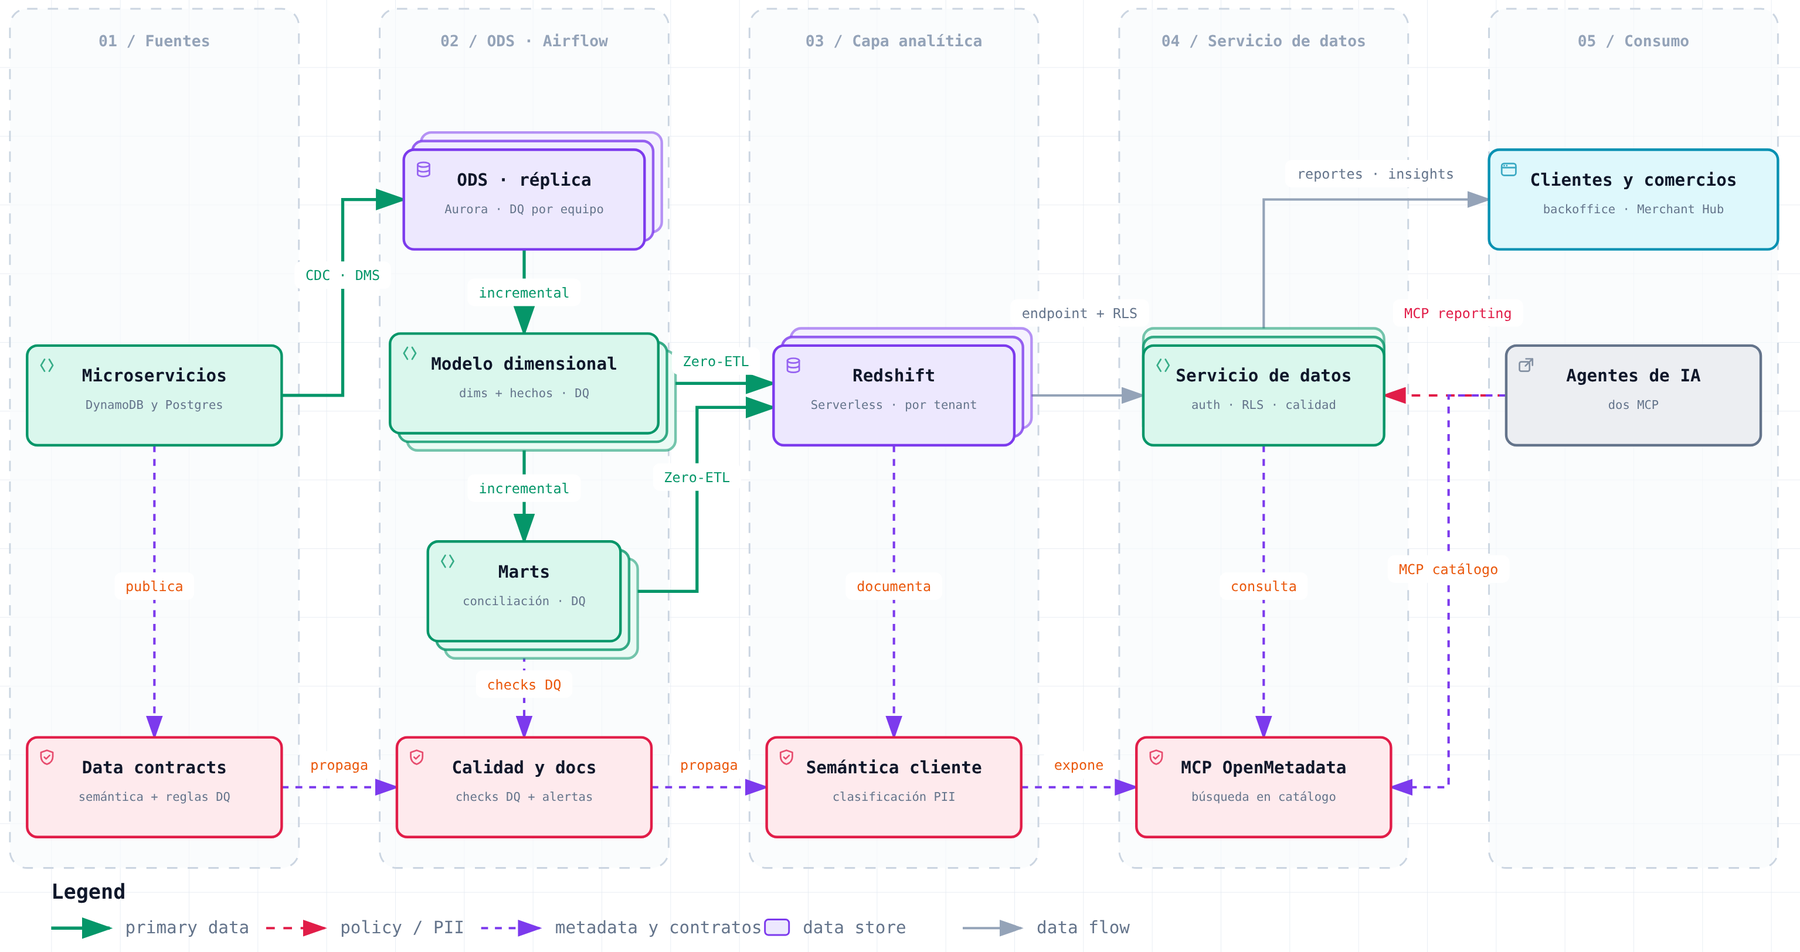 Pipeline de datos de punta a punta
Los datos se conectan cuando nace el servicio
El pago del principio nace repartido en varios microservicios, cada uno con su propia base de datos.
En muchas plataformas, sumar una fuente nueva es un pedido al equipo de datos que espera su turno. Cada extractor escrito a mano es una deuda que alguien tiene que mantener.
En Akua lo planteamos de la siguiente manera: la ingesta es una capacidad de la plataforma de ingeniería. Con el Internal Developer Portal, del que Luispe Toloy contó en este blog, un equipo lanza un microservicio y decide en el mismo paso si sus datos se replican. Todo es infraestructura como código y funciona igual con DynamoDB o PostgreSQL.
Así, cada parte de los datos que componen un pago llega casi en tiempo real a un mismo lugar, sin que nadie escriba una línea de integración.
Un único modelo para todos los tenants
Una vez juntos, los pedazos del pago tienen que encajar en una misma forma.
El primer destino es el Operational Data Store (ODS), un Aurora PostgreSQL por tenant. Ahí conviven los datos crudos de cada servicio, donde también los equipos de ingeniería pueden consultarlos en réplicas de lectura sin tocar producción.
Sobre el ODS construimos un modelo dimensional orquestado por Airflow. El mundo de pagos responde a un modelo con forma de estrella: cuánto, cuántas veces, aprobado o rechazado, por comercio, emisor, red y fecha.
- Dimensiones: comercios, clientes, instrumentos y BINs. Cada cambio agrega una versión nueva y nunca pisa la anterior.
- Hechos: transacciones, pagos con su ciclo de vida, evaluaciones de fraude y clearing.
- Marts: tablas para un uso de negocio, como la conciliación financiera, que une el ciclo del pago en una sola fila.
Acá se juega la primera exigencia, la exactitud. Cada hecho apunta a la versión del comercio vigente cuando ocurrió el pago: un reporte de marzo muestra la configuración de marzo. Reprocesar no cambia la historia.
Cada tenant puede estar en una versión distinta de la plataforma, pero todos comparten el mismo modelo. Fue la decisión que más nos rindió: lo que se construye encima sirve a un tenant nuevo desde el día uno.
Un banco nuevo no trae un modelo nuevo: trae datos al mismo modelo.
La confianza en los datos se diseña
Mientras el pago avanza, viaja en paralelo todo lo que lo explica.
Un dato exacto que nadie entiende no sirve para decidir. Por eso cada tramo del recorrido tiene su contraparte de metadata, gestionada en OpenMetadata como código:
- Data contracts: cada servicio publica la semántica de sus columnas y sus reglas de calidad. Quien genera el dato lo documenta.
- Calidad y docs: sobre el modelo y los marts corren checks de calidad, y los avisos llegan a Slack.
Semántica por cliente: en la capa analítica, cada columna hereda su descripción y su clasificación de datos sensibles. - Catálogo y lineage: todo termina en un catálogo con lineage por columna. Cualquiera puede ver de dónde sale un dato sin preguntarle a quien escribió el ETL.
El catálogo dice lo que el dato es, no lo que alguien recuerda que era.
Cada capa entra cuando el negocio la pide, no antes
Durante un tiempo, el pago se consultaba en el mismo ODS donde se transformaba.
Para empezar era la opción correcta: un solo lugar y cero integración. La capa analítica entró cuando coincidieron dos señales:
- Performance: a medida que creció el volumen, los dashboards analíticos empezaron a sobrecargar el ODS: un motor transaccional no está pensado para agregar períodos largos.
- Aislamiento: buscamos que los clientes también accedan a sus datos. Eso exige una frontera física que garantice seguridad, escalabilidad y aislamiento.
Hoy el modelo llega por Zero-ETL a un Redshift Serverless por tenant, sin pipeline de carga que mantener. El aislamiento tiene dos niveles:
- Por tenant: cada banco o procesadora tiene su propio Redshift. Sus consultas nunca compiten con las de otro, y el cómputo no se paga cuando no se usa.
- Por cliente: cada cliente tiene su propia base, únicamente con sus datos, con seguridad a nivel de fila (RLS) por organización, comercio, etc.
No arrancamos con esta capa, y no hacía falta. Sumarla no obligó a reescribir nada de lo anterior.
Una sola puerta para todos los datos
El último tramo es que el pago llegue a quien lo necesita, y solo a él.
Equipos internos, clientes, comercios y agentes piden datos todo el tiempo. Una arquitectura que soporte esto, con cada uno entrando por su lado, es lo que permite democratizar el acceso a los datos. Por eso construimos un servicio de datos propio, desplegado por tenant, como única puerta de entrada.
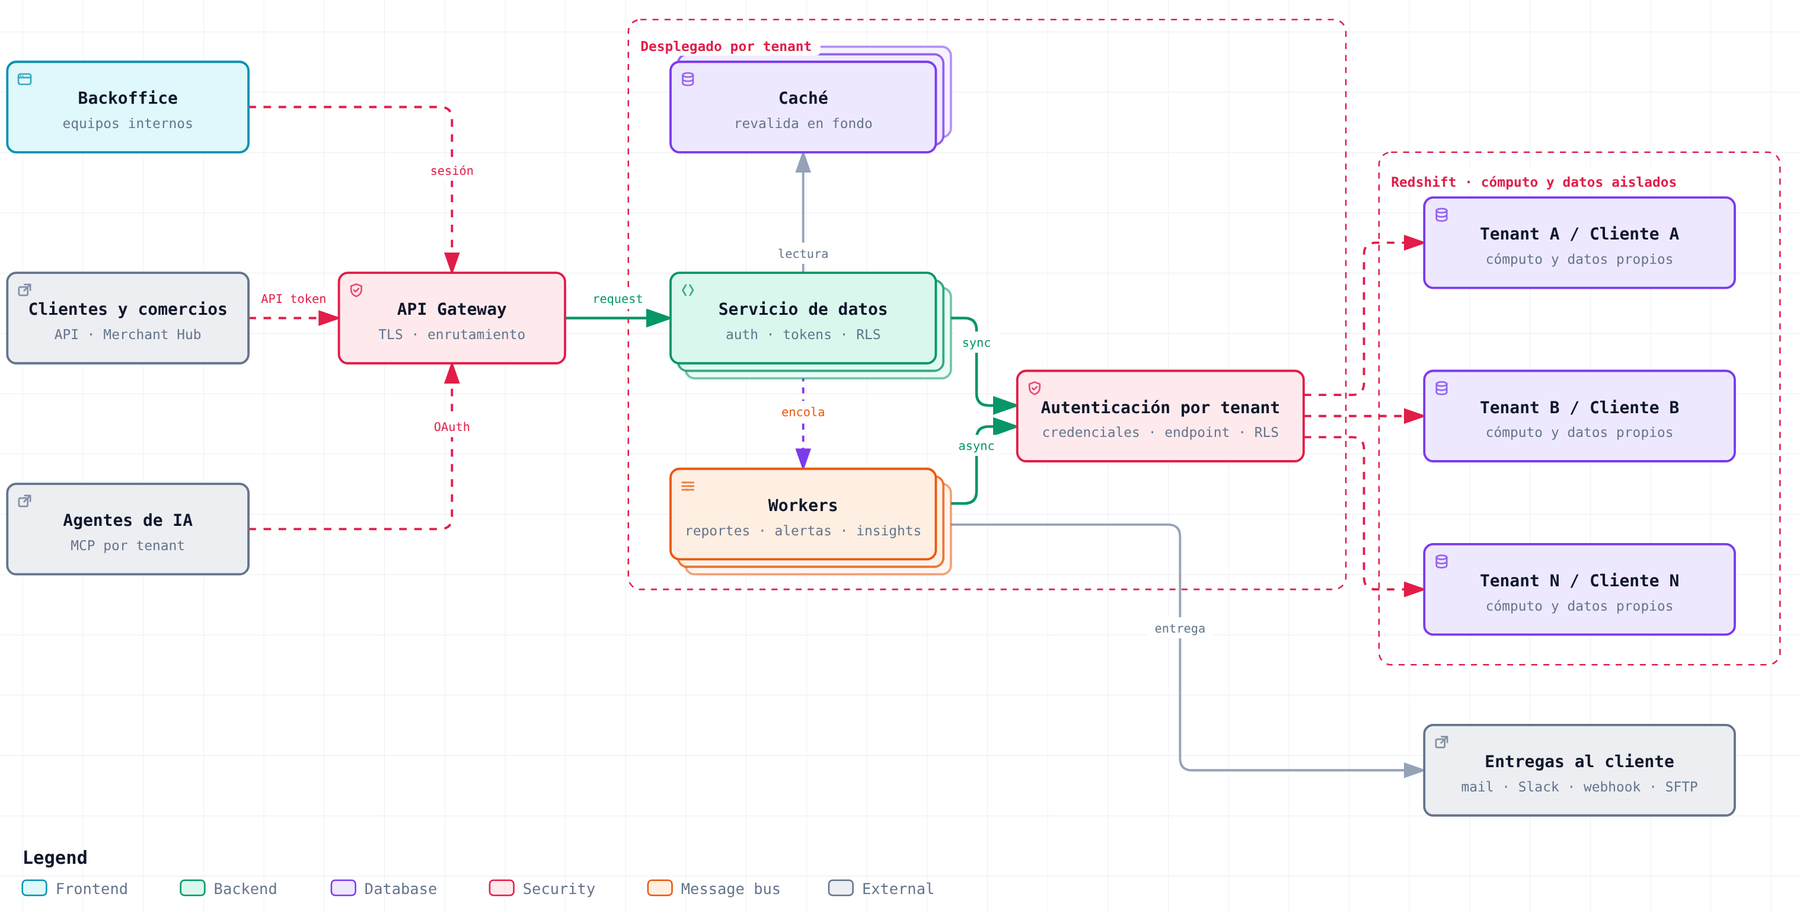
- Autenticación por tenant: cada consulta viaja con autenticación que permite identificar qué tenant, cliente o comercio representa y hasta dónde puede ver.
- API Gateway: recibe cada pedido con autenticación, venga del backoffice, de un cliente o de un agente, y lo enruta.
- Servicio de datos: recibe quién pregunta y sus credenciales, valida y redirecciona internamente las peticiones.
- Caché y workers: la caché responde al instante y se revalida en segundo plano. Los workers generan reportes, alertas e insights y los entregan por mail, Slack, webhook o SFTP.
En el último mes, este servicio atendió cerca de 1 millón de requests y ejecutó más de 1,7 millones de tareas en segundo plano. Un reporte ahí es configuración, no código: un template, una variante por país y una instancia por cliente. Y cada archivo pasa checks de calidad antes de ser entregado en el SFTP de un cliente.
El último consumidor de los datos de un pago no tiene que ser una persona
Ser AI native no significa darle a un modelo acceso a la base. Significa que la IA es un consumidor más del mismo servicio, con el mismo aislamiento. Por eso conectamos dos MCP que trabajan juntos:
- MCP de reporting: expone el servicio de datos. Un agente, o una persona desde su asistente, lista, crea y ejecuta reportes con las mismas reglas que la API.
- MCP de OpenMetadata: expone el catálogo: qué significa cada columna, de dónde sale y qué datos son sensibles. Es lo que le da al agente el contexto de negocio.
Así funciona el flujo:
alguien escribe
«necesito los rechazos por emisor de la semana pasada, con el fee neto».
El agente primero consulta el catálogo para entender cada concepto y qué columnas lo responden.
Después arma el reporte y lo ejecuta por el MCP de reporting, dentro de los límites de quien lo pidió.
Este flujo ya vive dentro de Cowork, el agente del dashboard de Akua. Cowork está conectado a los MCP de varios servicios y opera sus APIs de forma autónoma, siempre con los permisos del usuario autenticado. El identificador del cliente se inyecta desde la sesión y el agente tiene identidad propia: Santiago Barclay cuenta cómo lo aseguramos en Cómo implementamos AI de forma segura en Akua.
No nos casamos con la tecnología, nos casamos con los contratos
Volvamos al pago del principio. Nació repartido en servicios, encontró una forma común en el modelo, quedó explicado en el catálogo y llegó a cada actor por una sola puerta.
PostgreSQL, Redshift, Zero-ETL u OpenMetadata son decisiones de etapa. Lo que se mantiene son los contratos entre capas: un modelo único, un aislamiento que no se negocia y una calidad que se verifica antes de cada entrega.
Para quien esté diseñando la arquitectura de datos de una plataforma de pagos, estos son los tres principios que más nos rindieron:
- Modelar antes de escalar. Un modelo común desde el primer tenant vale más que cualquier motor analítico. Todo lo demás se construye sobre esa forma.
- Aislar por diseño. El aislamiento por tenant, cliente y comercio tiene que vivir en la arquitectura, no en el filtro de cada consulta. Vale igual para personas y agentes.
- Activar capas por señales del negocio. Cada componente entra cuando una señal concreta (performance o aislamiento) lo justifica. No antes.
Y esta tampoco es la versión final. La próxima capa ya tiene su lugar en el plan y va a entrar cuando el negocio la pida, sin que quien consume los datos note el cambio.